Moderne språkmodeller er i stor grad trent på tekst fra internett. Det betyr at de ikke bare lærer språk og fakta, men også normene, formuleringene og svarmønstrene som preger dagens digitale kultur. Resultatet er ofte svar som er forsiktige, generaliserte eller tilpasset moderne kommunikasjon på nett.
Jeg ønsket å teste et alternativ: Hva skjer hvis man trener en språkmodell uten moderne internetttekst?
I dette prosjektet trente jeg derfor en modell nesten utelukkende på eldre litteratur, altså tekster som i mange tilfeller har vært lest, kopiert og diskutert gjennom hundrevis eller tusenvis av år. Korpuset består hovedsakelig av religiøse tekster, klassisk filosofi, historiske verk og eldre skjønnlitteratur hentet fra Project Gutenberg.
Tanken bak eksperimentet er ikke nødvendigvis at eldre tekst automatisk gir en bedre modell. Idéen er heller at treningsdata påvirker hvordan en modell resonnerer og formulerer seg. Tekster skrevet i andre historiske perioder har ofte en annen stil: mer argumenterende, mer filosofisk, og mindre preget av dagens sosiale normer og standardiserte svarmønstre.
Ved å trene en modell på et slikt korpus kan man derfor undersøke hvordan svarene endrer seg når modellen lærer språk fra et helt annet kulturelt og historisk utgangspunkt.
I denne artikkelen går jeg gjennom hvordan modellen ble trent, hvordan tokenizeren fungerer, og hva som faktisk skjer når man lar en språkmodell lære nesten utelukkende fra gammel litteratur.
Hvorfor gjøre dette?
GIGO = Garbage inn, garbage out
Spesielt innenfor datavitenskap er konseptet om GIGO velkjent. Garbage In, Garbage Out beskriver det grunnleggende prinsippet at kvaliteten på et systems utdata er begrenset av kvaliteten på indataene systemet trenes eller opererer på. Innen maskinlæring og spesielt store språkmodeller er dette prinsippet ekstra viktig: en modell lærer ikke sannhet, mening eller kvalitet i seg selv, den lærer statistiske mønstre i dataene den eksponeres for. Dersom treningsdataene består av støy, feil, overfladisk språk eller inkonsistent struktur, vil modellen internalisere nettopp disse egenskapene. Resultatet blir en modell som produserer tilsvarende støy, inkonsistens og overfladiskhet.
Dette gjør datasamling og dataprosessering til en av de viktigste delene innenfor maskinlæring. Selv svært avanserte modeller kan ikke kompensere for et dårlig datagrunnlag, arkitekturen kan forbedre effektivitet og generalisering, men den kan ikke skape kvalitet der den ikke finnes. Derfor blir spørsmålet om hva slags tekst som inngår i et korpus avgjørende for hvor bra språkmodellen kan bli.
Hva skiller dagens litteratur og eldre litteratur som har blitt bevart, endret, oversatt og er fortsatt stort sett tilgjengelig i dag? Den litteraturen som noen har brukt mye ressurser på å holde i live har bestått en kvalifikasjonstest, en test som gjør at vi kan være nesten helt sikker på at teksten overgår typiske overfladiske verk som produseres hele tiden. Tekstene har bestått tidens krav. Derfor kan vi anta at tekstene i en korpus med gammel litteratur kun inneholder tekst med substans (i alle fall hovedsakelig).
Gjennom generasjoner har de blitt kopiert, oversatt, kommentert og utgitt på nytt. Hver av disse prosessene innebærer også at noen har tatt en avgjørelse om det er verdt å ta vare på teksten, kun tekster som anses som viktige, interessante eller verdifulle nok får denne behandlingen. Mange samtidige tekster forsvinner uten spor, mens enkelte verk overlever nettopp fordi de oppleves som betydningsfulle.
Hvordan endres tekst over tid?
De største endringene en tekst opplever skjer når teksten ikke er skrevet ned men spres muntlig (naturligvis), men dette er ikke den eneste måten en tekst forandres. Dersom man skal referere til en tekst, enten muntlig eller skriftlig, er det naturlig å gjengi en forkortet oppsummering av dette i stedet for å gjengi alle detaljene. Denne oppsummeringen er en betydelig endret versjon av den originale teksten. Det er en måte å beskrive veldig presist hvordan arketypen for endring av tekst gjennom tid ser ut, tenk gjennom dette:
Teksten endrer seg gjennom tid ved å optimalisere for å være lettest mulig å huske.
Over tid vil derfor historier som er lette å huske ha større sjanse for å overleve. Fortellinger som er rotete, lange eller vanskelige å gjengi blir oftere glemt, eller forenklet. Resultatet er at litteratur som har blitt videreført gjennom mange generasjoner ofte inneholder nettopp slike mønstre – rytme, repetisjon og tydelige strukturer som gjør teksten lettere å huske og gjenfortelle.
Virkemåte
Treningsdata
Modellen er trent hovedsakelig på tekster fra Project Gutenberg, et digitalt bibliotek med over 70 000 bøker med utløpt opphavsrett. Korpuset består hovedsakelig av religiøse tekster, klassisk filosofi, antikk historieskriving og eldre skjønnlitteratur. Bibelen utgjør en stor del av datagrunnlaget, men korpuset inkluderer også verk som Homers Iliaden, Platons dialoger og tidlig engelsk prosa.
Jeg brukte Project Gutenberg som grunnlag, og lastet ned en liten andel av alt som er på project gutenberg. Jeg endte med omtrent 3 milliarder tegn etter prosessering, omtrent 593 millioner ord, fordelt på 10 706 forskjellige bøker.
Tekstene ble lastet ned som .txt-filer og deretter renset for irrelevant innledning og avslutning (for eksempel referanser, fotnoter, osv), deretter satt gjennom en rekke automatiske tester for å verifisere at de kan brukes. Eksempelvis ble tekster på andre språk enn engelsk filtrert bort.
Tokenizer
For at en språkmodell skal kunne forstå setninger må den dele dem opp, for mennesker er det naturlig å tenke at en språkmodell kan dele setninger på mellomrom, slik at vi går fra Sola står opp i øst, blir sola står opp i øst. Dette er et rimelig forslag, og er sånn ML-modeller fungerte før, men det er en rekke problemer med dette. Blant annet var det praksis før å bytte ut ord som ikke fantes i ordlista med ett arbitrært symbol som betyr at ordet er ukjent (for hva skal man ellers gjøre med ukjente ord?). Dette fører potensielt til store menger datatap, enten hvis ordlisten ikke er lang nok eller brukeren gjør en enkel skrivefeil som autokorrektur ikke klarer å rette.
Alle ordene deles opp i det som heter tokens, en token er enten en del av et ord, men kan også være tegn som komma, punktum, tall også videre. Når tokenizeren trenes finner den delord som statistisk sett ofte følges av andre delord. For eksempel så kan en sammenslåing være definert på følgende måte:
Hvis jeg finner et delord som er
d, og det etterfulges avet, skal jeg slå sammen delordet til å blidet.
Tokenizeren består av mange tusen slike regler. Dersom vi skal prøve å forstå hvorfor det er gunstig å del ord på denne måten kan vi for eksempe sammenligne det med å sette -ing bak et ord (eksempelvis løping, klatring). I dette tilfellet vil ing ha en spesiell betydning for oss mennesker hvor vi kan bygge en forståelse for hva løp betyr, deretter hvordan -e (løpe) eller -ing (løping) endrer betydningen, fordelen her er at -e og -ing endingen fungerer til flere verb. En tokenizer fungerer delvis på samme måte, bare at det sjeldent er så tydelig skilt som -ing.
Alle delordene språkmodellen slår sammen står definert i en egen fil som følger med tokenizeren. Dette er et utdrag av hvordan denne filen ser ut på den modellen jeg trente:
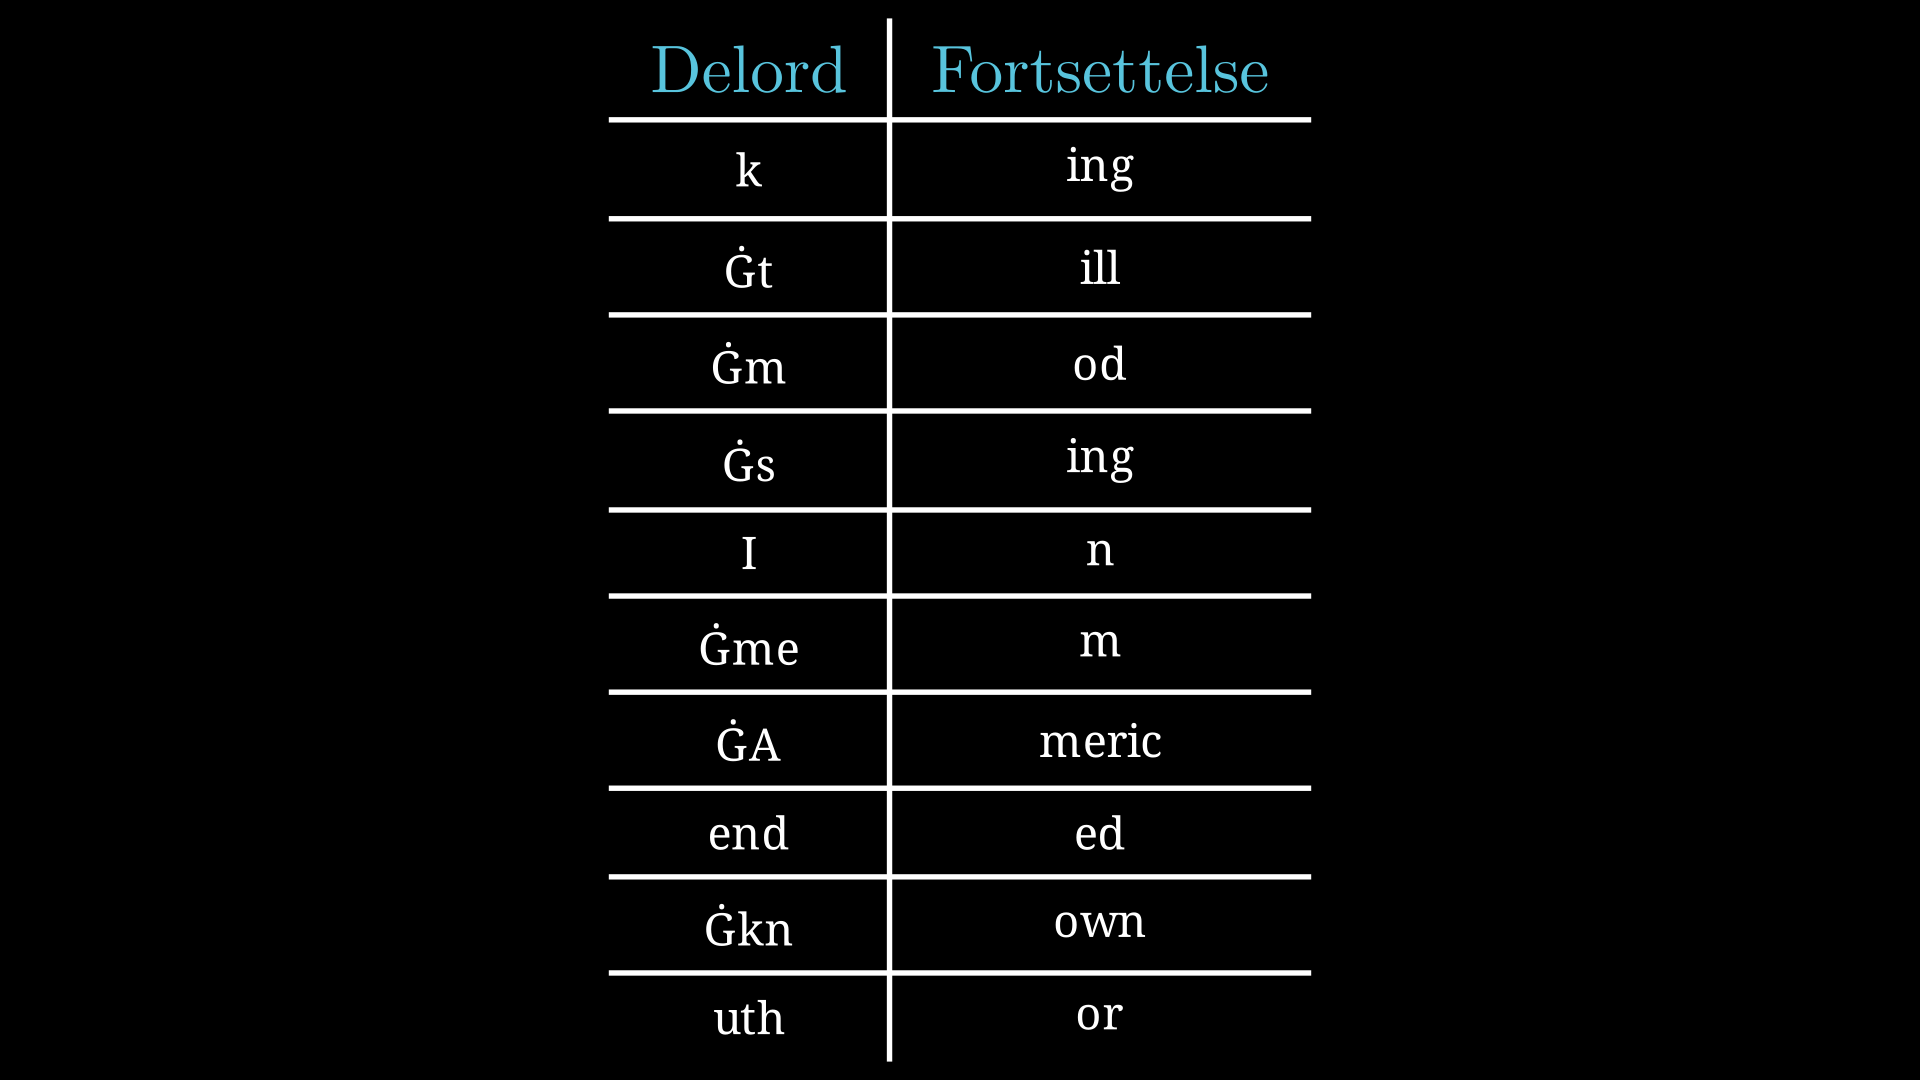
Som du ser på tabellen inneholder den et tegn som går igjen: Ġ. Dette er et spesialtegn den bruker i stedet for mellomrom, det vil si at sing ikke er definert eksplisitt i tabellen over, men mellomrom + s etterfulgt av ing blir gjort om til mellomrom + sing. Husk at når du ser Ġ betyr det mellomrom.
Dersom tokenizeren møter på 'end', 'ed' vet den på grunn av denne tabellen at den skal slå de sammen til 'ended', tabellen fungerer også ved at de sammenslåingene som står høyere oppe får høyere prioritert.
Her er forløpet til tokenizeren:
- Modellen går gjennom setningen, sjekker om det finnes en måte å slå sammen 2 delord på.
- Modellen gjentar dette helt frem til det ikke er mulig slå sammen flere delord.
Her ser du hvordan Lorem Ipsum Dolor blir slått sammen, den starter med at alle bokstaver er delt (L o r e m ...):
Etter 10 runder med sammenslåing klarer ikke tokenizeren å slå sammen flere delord. I eksempelet over endte vi opp med ĠL ore m ĠI ps um ĠDol or.
Det at vi endte opp med såpass mange delord er et tegn på at Lorem Ipsum Dolor er nogenlunde ukjent for modellen. Siden modellen er trent mye på bibelen, kan vi prøve et mer gjenkjennbart ord og se om det gir annet resultat:
Her kan du se at disse 2 ordene har språkmodellen vært mye mer eksponert for under treningen, og har derfor to konkrete delord dedikert for the og genesis.
Etter at setningen har blitt delt opp i største mulige delord blir de gjort om til tall (husk: datamaskiner jobber kun med tall, så dette måtte skje en eller annen gang.)
Transformer og attention
Etter at setningen er tokenisert og gjort om til tall, sendes disse tallene inn i selve modellen – en transformer. Transformeren er arkitekturen som ligger bak nesten alle moderne språkmodeller, og ble introdusert i 2017 i artikkelen Attention Is All You Need.
Kjernen i transformeren er en mekanisme som heter attention. Attention gjør at modellen kan vektlegge hvor mye hvert ord i en setning skal bry seg om de andre ordene. Ta setningen:
Kongen mistet kronen sin fordi den var for stor.
Her må modellen forstå at den refererer til kronen, ikke kongen. Attention løser dette ved at hvert ord ser på alle andre ord i setningen og beregner hvor relevant hver av de er i sammenheng med seg selv. Dersom modellen skjønner at det er kronen som er for stor burde den vil få en høy score mot kronen, og en lav score mot kongen. Dette er måten språkmodeller kan forstå sammenheng mellom ord.
Dette skjer ikke bare én gang – modellen kjører mange slike attention-beregninger parallelt, kalt multi-head attention. Hver utregning kan lære seg å fokusere på ulike typer relasjoner: grammatikk, semantikk, avhengigheter mellom setningsledd også videre.
Her er attentionverdiene jeg fikk fra modellen når jeg kjørte den med setningen I saw the man with the telescope:
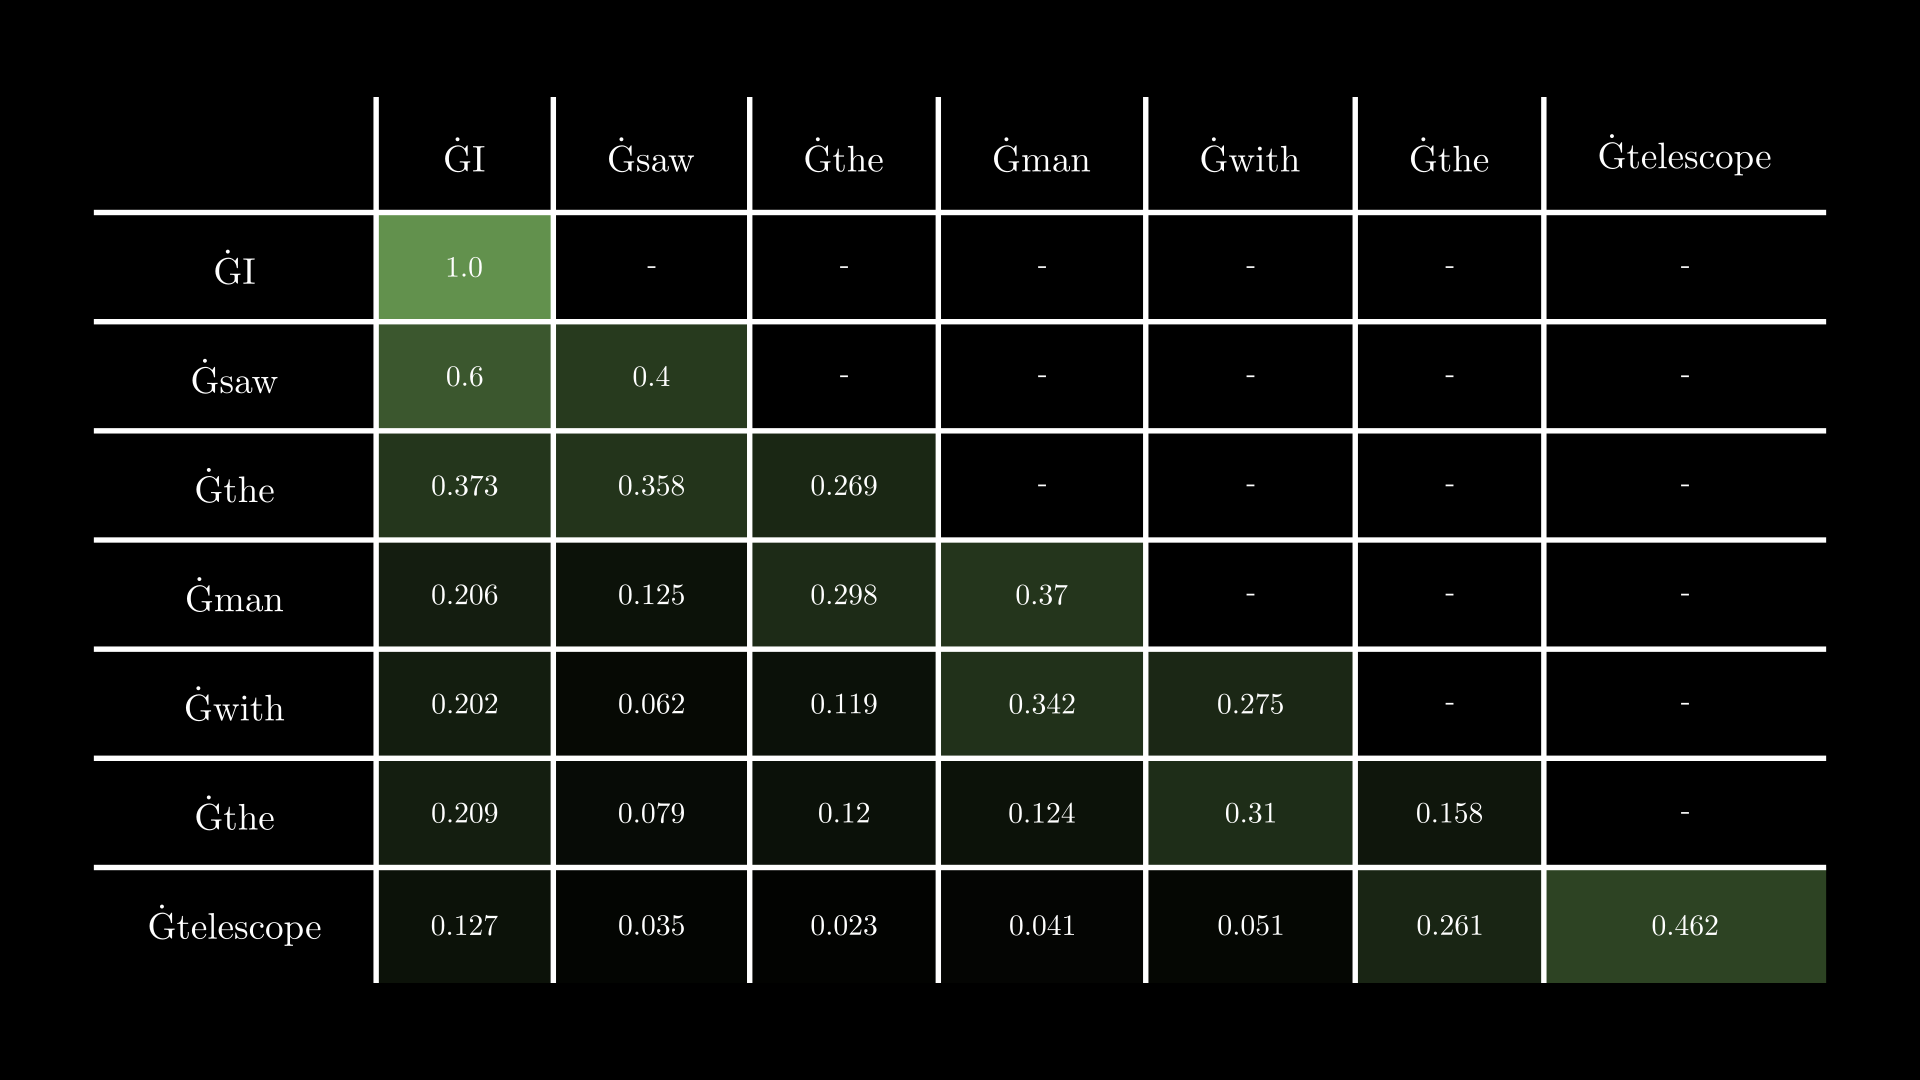
(Husk: modellen har ikke generert et eneste ord enda, dette er analysen modellen gjør av ordene jeg ga den.)
Hver rad representerer ordet modellen prøver å sette i kontekst, og hver kolonne sier hvor mye hvert ord påvirket dette ordet. For eksempel: ordet saw ble mer påvirket av I enn saw (helt konkret ble den påvirket 60% av I, og 40% av saw).
Jeg ga modellen hele teksten: i saw the man with the telescope, og det er i utgangspunktet ikke noe i veien for at i ikke skal kunne få attention fra alle andre ord samtidig, men av konvensjon er det implementert sånn at den kun ser ordene som kommer før i setningen, med andre ord: I ser kun I, derfor får den 100% attention. saw derimot, ser I og saw, derfor er attention fordelt mellom de to.
Resultatene
Jeg startet med GPT-2-arkitekturen, men startet fra scratch med treningen. Jeg trente modellen omtrent 3 ganger på korpuset jeg produserte fra Project Gutenberg, hver runde tok et sted mellom 10-20 timer. Modeller som ChatGPT er først trent på store mengder generell tekst som et utgangspunkt, deretter spisses den ned og trenes spesifikt på å svare på spørsmål, jeg har ikke gjort sistnevnte. Av den grunnen er modellen kun egnet til å fortsette setninger, men jeg prøvde å sette den inn i en slags assistent rolle ved å gjøre teksten om til spørsmål-svar variant, så istedet for å gi den What is the meaning of life? gir jeg:
Scholar: What is the meaning of life?
Scribe:
Normalt hadde modeller benyttet seg av User: og Assistant:, men denne modellen er nesten ikke trent på user i den forstand, så det er jeg valgte mer egnede ord med tanke på dataen modellen er trent på.
What is the meaning of life?
svar:
"What do you propose to do?" As I was about to speak, a man arose, pointing to the power of Mr. Stanton, and in one of his eloquent pauses drew his chair. "Well," he said, "I shall have you in my carriage." As he spoke, the company pressed round his chair and asked, in a low voice, what was the matter. As Mr. Stanton was about to mount his whip and ascend the mountain side, he could not see the danger of his jumping into the valley. The next day the train goes by rail, and Mr. Stanton, who had been up the hill, shouted, "Hold, all of you! Doo! please!" Mr. Stanton came and took my tidings of the arrival of the great The train went by rail. The last day we heard the last of the voyage, and as Mr. Stanton was a member of the International Council of Women, we went straight from Oswego, on the starboard bow and
Modellen klarer å opprettholde en konsistent stil og tone over flere setninger, men mister den logiske tråden over lengre tekst. I tillegg stopper den brått. Dette er typisk for mindre modeller uavhengig av treningsdata. Modellen svarer ikke filosofisk på spørsmålet slik en moderne LLM ville gjort – i stedet fortsetter den teksten som om den var midt i en fortelling. Dette er forventet oppførsel, siden modellen ikke er trent til å svare på spørsmål.
Kanskje vi kan finne svar på spørsmålet ved å omformulere det på denne måten: The meaning of life is, deretter burde språkmodellen kunne gi svaret gjennom å bare fortsette setningen:
The meaning of life is to us a source of intense satisfaction and enjoyment. The beautiful, the beautiful, and the exquisite beauty of the heavens above. As we look back with all its many associations and its many phases and interests, we feel how little our labors are appreciated and appreciated. But we see no signs of the final perfection of life in living life, never hands over one's own shoulders or hands on the same bosom as in that of the most beautiful daughters. I saw them, too, when they were children, never less charming than when men and women had a world of glory and freedom for all mankind. They are, however, not unlike the sun and stars, nor as the moon and stars. Their virtues and opinions are not alike in the same light with their brilliant colors, nor their virtues, which they often affect, as they appear, to do or dare; hence their power is as stable as usual in the presence of God--the most honored and respected in the nation,--and those who say, "The first glimpse I have of the sun is on the sky and the earth and the coldest of the day is on my head." To be rudely gazed at the stars from a house and grounds, one would think they would be cruel to call on a man and woman to repentance
Modellen produserer nogenlunde korrekte setninger med et ordvalg som passer korpuset, og klarer å holde seg innenfor samme tematiske felt over flere setninger. Det den svikter på er logisk nivå, setningene følger hverandre assossiativt ovenfor logisk.
Her er flere eksempler jeg testet:
Death is nothing but
svar:
Death is nothing but a dream of eternity. In the spring she went to Europe, and then returned and sailed for England. As soon as we reached their native shores and made their last descent on the Continent, Mrs. Stanton and her faithful coadjutor came with a few fleet of ships and four thousand men and women, to join in the work, and to help the cause of the work. Mrs. Blatch had just returned from a flying visit to America, having made an earnest tour through the country, and we were invited to dine with her at her home, where she was to remain her prisoner until her friends should have presented her with a declaration that they had heard enough for the voyage; while the rest of us sat outside of our respective apartments, waiting to take us ashore. The night was dark and stormy, the sky clear, and the deep-toned organ filled me with consternation. My daughter and I attended the World's Anti-slavery Convention, held meetings there every day, and made many pleasant acquaintances with Mrs. Willard, who has always been a faithful friend and coadjutor. She and Mrs. Devereux Blake were much connected with Mrs Sage's life, and one of the best speeches she made on the occasion was "In the Opera House," in which Mrs
The greatest virtue is
svar:
The greatest virtue is the great educational work of my beloved Susan B. Anthony, and it is the work of her handmaid, a beautiful girl of thirty years and more than any other department in the higher departments of knowledge. Her first work on the "Open the Door," written for a monthly report in the _Salon_ of April, 1888, is to educate the younger children of the higher class of girls into a perfect knowledge of all questions and figures in every word and look. She has not only mastered the languages, mathematics, and logic but has learned French, and has never been able to purchase them. On November 16, 1887, she went to Europe, to visit Mrs. Margaret Bright Lucas, the novelist and editor of the _Commentaries_ in which she gave us a warm welcome. As Mrs. Gladstone had presented me with her most fitting words, and as Mrs. Lucas was about to close the doors open, I joined her, after a hasty good-night, at the Savoy Hotel, where she was to sit in the next house and enjoy a few days' conversation with her mother and her sister Miss Lord and Mrs. Stanton. The little portmanteau, stuffed with facts and papers, was filled with documents and magazines, and many others, including
Prosjektet overgikk forventningene mine når det kommer til ordvalgene til modellen, jeg hadde ikke forventet at en så liten modell trent på et såpass begrenset korpus skulle klare å produsere tekst som faktisk ligner på litteraturen den er trent på. Likevel er det åpenbart hva som mangler: modellen er umulig å ha en samtale med. Den fortsetter tekst, den svarer ikke på spørsmål, og den har ingen intensjon bak det den skriver. Neste steg ville være mer trening, for å lære modellen å faktisk svare på det man spør om, men det er en helt annen treningsprosess som krever et helt annet datasett.